Posts
1064
Practical notes on AI assistants, software architecture, and developer tooling.
Posts
1064
Tags
725
Featured
0
一次响应要 1.5 分钟,CPU 报告却只有 6.7%。微软团队用一次真实排查说明:先定位是哪个进程,再用 CPU 报告排除计算,最后用 Stopwatch 量出循环里累计的 10 秒等待。
Continue reading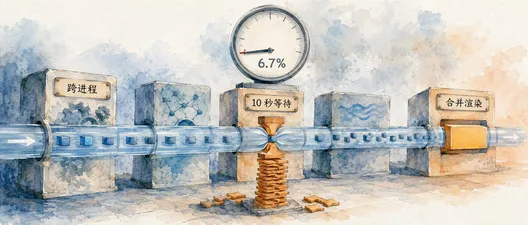
一次响应要 1.5 分钟,CPU 报告却只有 6.7%。微软团队用一次真实排查说明:先定位是哪个进程,再用 CPU 报告排除计算,最后用 Stopwatch 量出循环里累计的 10 秒等待。
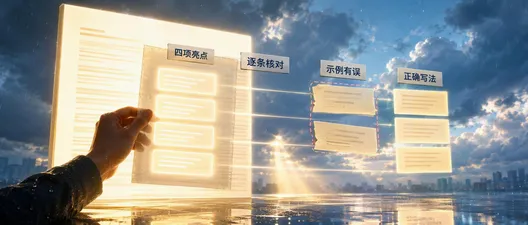
容器、DNS、崩溃报告、C# 15 union、WinForms kiosk:一篇 .NET 11 RC1 亮点文章里的每个特性,我都对着官方发布说明核了一遍。哪些是真的、哪些代码写错了、正确用法是什么,以及原文漏掉的开关与参数。
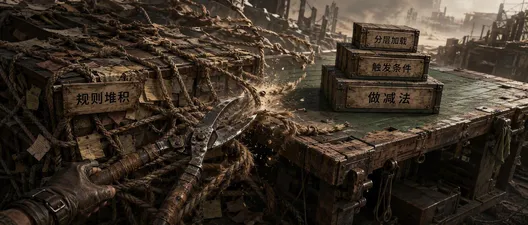
新模型更强,旧提示词却可能变成负担。本文整理 OpenAI 对 GPT-6 Astra 的行为说明,并给出缩短 skill 描述、给 AGENTS.md 加触发条件、把边界说到可执行的具体做法和迁移清单。
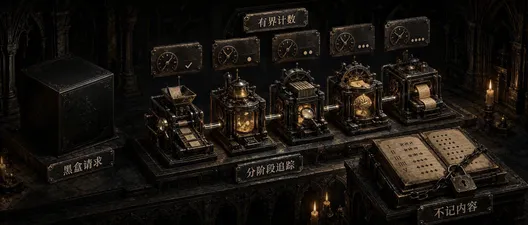
一次 RAG 回答变慢,未必是模型慢。本文整理 .NET 管线的追踪契约:把嵌入、检索、重排、拼装提示词和生成拆成同一 trace 下的 span,只带版本标识与有界计数,离线评测与在线观测靠版本号关联。
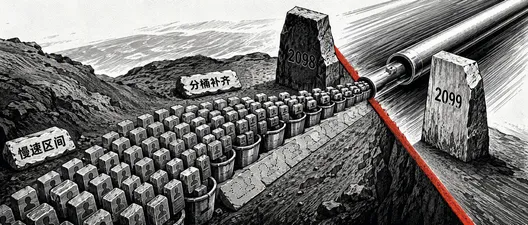
EF Core 10 把参数化集合默认翻译成每个值一个参数,可用上限其实是 2098;越界不报错,只是悄悄变慢。本文整理分桶补齐规则、七种写法的实测对比、计划缓存代价,以及复合键列表为什么必须换写法。
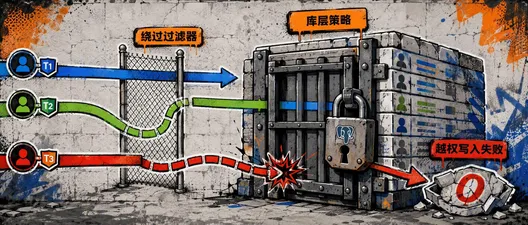
EF Core 查询过滤器管不到原生 SQL、附加实体和 IgnoreQueryFilters。用 Postgres 行级安全策略在数据库层补上第二道防线:角色拆分、每次连接设置租户、绕过验证、计划代价与运维边界。
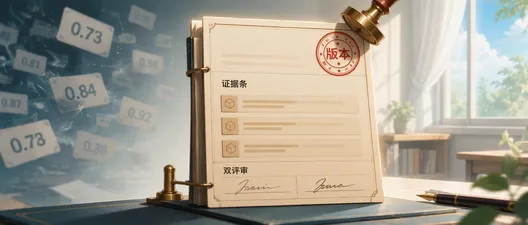
RAG 黄金评测集是评测的证据契约:每个用例记录查询、预期答案、支撑 chunk、来源版本和人工评审,缺一项就难以复核。本文说明如何构建、校验、用合成数据补候选、用人工校准并随证据更新。
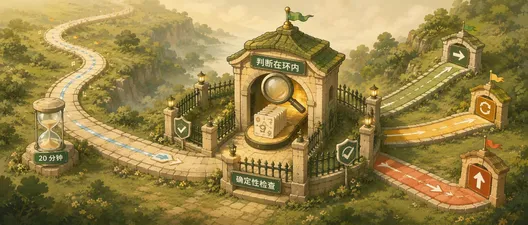
LLM judge 正从离线评测走进 agent 运行时,开始影响继续、重试、换模型或转人工。本文拆解 7 种架构模式,说明如何拆分判断、比较候选、检查过程,并用确定性逻辑控制风险。
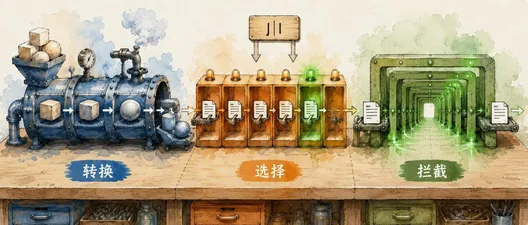
Pipeline、职责链与 ASP.NET Core 中间件都像一串组件,真正的区别是谁拥有 continuation、组件被期望做什么。对照转换、选择与拦截三种契约,配可运行示例、短路含义与顺序解读,帮你命名并审查现有设计。
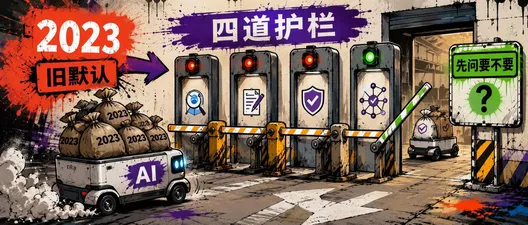
AI 代理按 2023 年的默认值选 .NET 库,而 AutoMapper、MediatR、MassTransit 已商业化。用 NuGet MCP Server、指令文件、构建门禁与中央包管理四道护栏挡住错误,附 2026 许可现状表。
IAsyncActionFilter 在操作方法前后运行异步检查:OnActionExecutionAsync 包裹 next() 委托可短路请求。用邮箱验证过滤器讲清注册、应用与验证,以及何时改用授权过滤器。